PROGETTO ENEA-CRESCO
DOCUMENTAZIONE TECNICA
Sommario
Sottosistema a dischi ad alte prestazioni e
tape library
Sistema
di alimentazione e di continuità
Introduzione
Il sistema di
supercalcolo fornito è composto da
quattro sezioni computazionali, tutte installate nella sala macchine della sede
ENEA di Portici:
- SEZIONE 1 :
cluster costituito da nodi IBM x3950 M2
- SEZIONE 2: cluster costituito da 256 nodi IBM
- SEZIONE 3:
cluster costituito da 4 blade server IBM QS21, basati su processore IBM CELL
- SEZIONE 4:
cluster costituito da macchine x3755 dedicate
Si cerca nel
presente documento di riassumerne la composizione in modo descrittivo,
approfondendo solo alcuni aspetti, al fine di introdurre i documenti tecnici che riportano in modo dettagliato la
struttura di ogni singola macchina implementata e della infrastruttura
considerata con un alto livello di dettaglio.
Sistema di supercalcolo HPC
Sezione 1
La sezione 1
è composta da 42 nodi di calcolo di cui riportiamo in modo riassuntivo le
caratteristiche
34
nodi (3850 M2)
- 4 processori Xeon Quad Core 2.4GHz
(16 core)
- 32GB di memoria RAM DDR2 (2GB per
core)
- 2 dischi SAS da 73,4
GB 10K
- 1 Cisco Single-port 4X
DDR IB PCI-E HCA
- Doppia connessione ad 1 Gbit
Ethernet
-
Sistema di controllo integrato per l’ottimizzazione dell’assorbimento elettrico
in funzione del carico
- Alimentazione
ridondata
- Connessione al sistema
storage ad alte prestazione tramite la rete Infiniband 4X
8 nodi:
- 4 processori Xeon Quad Core 2.4GHz (16
core)
- 64GB di memoria RAM DDR2 (4GB per
core)
\ - 2 dischi SAS da 73,4 GB
10K
- 1 Cisco
Single-port 4X DDR IB PCI-E
- Doppia connessione ad 1 Gbit
Ethernet
- Sistema di controllo integrato per l’ottimizzazione
dell’assorbimento elettrico in funzione del carico
- Alimentazione
ridondata
- Connessione
al sistema storage ad alte prestazione tramite la rete Infiniband 4X
La Sezione comprende inoltre:
4
server di front end
x3650 (Scheda) con 2 processori Quad
Core 2,33 GHz (8 core) con 2 Gb di ram
4
server di front end grafico x3655 (Scheda)
con 2 processori Dual core 2 GHz (4 core) con 2 Gb di ram
4
server x3650 con 2 processori Dual core (4 core) 1,8 GHz con 8 Gb di ram
adibiti alla gestione dei file system GPFS
3
server x3650 con 2 processori Quad core 2,00 GHZ con 8 Gb di ram adibiti alla
gestione del sw di backup
6
server x3650 con 1 processore Dual core 1,87 GHz con 2 Gb di ram adibiti a
server per le installazioni distribuite e come server licenze e server per il
sw IBM Director
15 server x3550 (Scheda) con 1 processore (1 core) con un
Gb di ram
2
server x3550 con processore Quad core 2,00 Ghz con 3 Gb di ram adibiti a
file server Afs, collegati via SAN ad uno storage DS4200
Sezione 2
IBM BladeCenter H , all’interno di un rack, occupa 9 unità offrendo la possibilità di ospitare, al suo interno, sino a 14 blade servers, ma anche tutte le funzionalità di I/O, alimentazione e raffreddamento dei sistemi.
Le due unita’ aggiuntive rispetto al Bladecenter classico sono necessarie ad ospitare ulteriori funzionalita’ switching High-Speed, particolarmente indicate per il mondo High-performance, oppure switch “legacy” LAN/FC aggiuntivi. E’ chiaro che il BC-H presenta le stesse caratteristiche nelle applicazioni in cui e’ normalmente utilizzato il Bladecenter, come:
- server consolidation;
- dynamic Web serving;
- application service providers;
- cluster Linux;
- calcolo scientifico e parallelo;
- terminal serving e Active directory
services;
rendendosi adatti a soluzioni Citrix, Lotus Notes e Microsoft Exchange. Di seguito le principali funzionalità e tecnologie innovative implementate nel BladeCenter H:
- design da 9 unità;
- fino a 14 Blade Servers QS21;
- fino a 4 BC-H in un rack 42 unità;
- fino a 8 switch “legacy” (Ethernet, FC,
Infiniband 1x ecc.), fino a 4 switch “High Speed” Infiniband 4x o 10Gb
Ethernet, fino a 4 “Bridge Modules” Ethernet o FC;
- tutti gli switches possono coesistere all’interno dello stesso chassis e sono intercambiabili tra gli chassis. Gli switch “High Speed” e i “Bridge Modules” sono utilizzabili solo sul BC-H;
- componenti ridondati ed hot-swap per i seguenti sottosistemi: alimentatori, ventole di raffreddamento, connessioni Ethernet e Fibre Channel;
- PFA su Processori, Memoria, Dischi, Ventole e Alimentatori
- Advanced Management Module (AMM) per console locale e remota e gestione web-based, opzionalmente ridondante;
- IBM Director e Remote Deployment Manager (RDM) per gestione centralizzata e deployment remoto;
- Media Tray che include 1x Hot-swap USB 2.0 DVD-ROM/CD RW, 2 porte USB 2.0 frontali, switch KVM per i 14 Blade server integrato nell’ Advanced Management Module. Opzione per virtualizzare (c-KVM e c-Media) e permettere l’accesso simultaneo, locale e remoto, al KVM e al Media Tray (opzione da acquistare sulla singola Blade);
- porta RS-232 della singola Blade accessibile sul retro tramite breackout cable (opzionale).
BladeCenter H offre maggiori prestazioni grazie a fabric finoa 10Gb, alimentatori più potenti ed un sistema di raffreddamento più efficiente. Si tratta quindi della piattaforma ideale per eseguire applicazioni critiche che necessitano di elevate prestazioni.
Fino a 4 chassis possono essere ospitati in un rack da 42 unit, limitando moltissimo l’ingombro di (fino a) 56 servers in un solo rack; anche il cablaggio risulta essere notevolmente ridotto, in quanto tutto il rack, nella massima configurazione, richiede di 2 cavi di alimentazione, le connessioni ethernet (fino a 24 per chassis) e FC (fino a 12 per chassis.
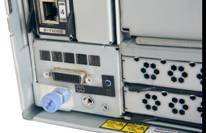
Il Media Tray è un’unità hot-pluggable che contiene una scheda di interfaccia e un DVD-ROM. Montati sulla scheda di interfaccia ci sono due porte di tipo USB 2.0 e dei led (Light Path Diagnostics) che forniscono informazioni sull’intero sistema. Le stesse informazioni soin riportate sul retro come mostrato nella seguente figura (oltre che nell’ event Log dell’ Advanced Management Module). E’ presente inoltre una porta seriale con la quale comunicare con ciascun BladeServer.
Lo chassis del BladeCenter H IBM, analogamente al BladeCenter classico, può ospitare molte componenti hot-swap e ridondate, come ad esempio:
- Alimentatori
- Switch di rete
- Moduli di management
- Ventole di raffreddamento
La figura seguente riassume il posizionamento dei vari componenti sul retro dell’IBM BladeCenter H.
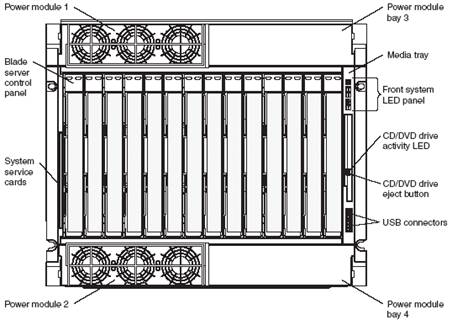
La figura seguente riassume il posizionamento dei
vari componenti sul retro dell’IBM BladeCenter H.
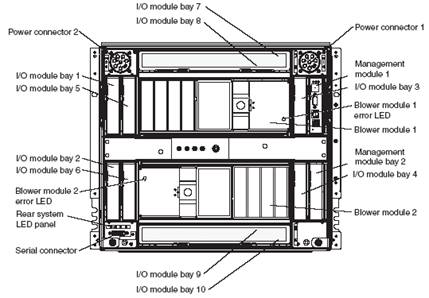
Si compone di
256 nodi di calcolo IBM_HS21 con 2
processori Quad Core 2,33 GHz con 16 Gb di ram inseriti all’interno di 19 IBM
BladeCenter H.
IBM BladeCenter H., all’interno di un rack, occupa 9 unità offrendo la possibilità di ospitare,
al suo interno, sino a 14 blade servers, ma anche tutte le funzionalità di I/O,
alimentazione e raffreddamento dei sistemi.
Le
due unita’ aggiuntive rispetto al Bladecenter classico sono necessarie ad
ospitare ulteriori funzionalita’ switching High-Speed, particolarmente indicate
per il mondo High-performance, oppure switch “legacy” LAN/FC aggiuntivi e ventole
e Alimentatori
Fino a 4
chassis possono essere ospitati in un rack da 42 unit, limitando moltissimo
l’ingombro di (fino a) 56 servers in un solo rack; anche il cablaggio risulta
essere notevolmente ridotto, in quanto tutto il rack, nella massima
configurazione, richiede di 2 cavi di alimentazione, le connessioni ethernet
(fino a 24 per chassis) e FC (fino a 12 per chassis).
Il Media Tray
è un’unità hot-pluggable che contiene una scheda di interfaccia e un DVD-ROM.
Montati sulla scheda di interfaccia ci sono due porte di tipo USB 2.0 e dei led
(Light Path Diagnostics) che forniscono informazioni sull’intero sistema. Le
stesse informazioni soin riportate sul retro come mostrato nella seguente
figura (oltre che nell’ event Log dell’ Advanced Management Module). E’
presente inoltre una porta seriale con la quale comunicare con ciascun
BladeServer.
Lo chassis
del BladeCenter H IBM, analogamente al BladeCenter classico, può ospitare molte
componenti hot-swap e ridondate, come ad esempio:
- Alimentatori
- Switch
di rete
- Moduli
di management
- Ventole
di raffreddamento
La figura
seguente riassume il posizionamento dei vari componenti sul retro dell’IBM
BladeCenter H.
La figura seguente riassume il
posizionamento dei vari componenti sul retro dell’IBM BladeCenter H.
La sezione è
inoltre fornita di 4 server di front
end x3650 con 2 processori Quad Core 2,33 GHz (8 core) con 2 Gb di ram e di 4 server di front end grafico x3655 con
2 processori Dual core 2 GHz (4 core) con 2 Gb di ram.
Sezione 3
Nell’ambito
del progetto CRESCO è previsto lo sviluppo di specifici tool per l’utilizzo del
Cell Processor, prodotto da IBM. Sono pertanto fornite 4 lame blade QS21 basate
sul processore Cell Broadband Engine (BE).
Ogni singola
lama QS21 è configurata come segue:
- 2
CPU 3.2 GHz Cell Broadband Engine™ technology (Cell
BE)
- 1 GB 3.2-GHz XDR DRAM, 2 channels per processor
- Dual Gigabit Ethernet port
- Cisco Systems 4X Infiniband Expansion Card for IBM BladeCenter
- 40 GB IDE HDD
- connessione al
sistema storage ad alte prestazioni garantita in tecnologia Infiniband
|
Part Number |
Description |
Qty |
|
|
BladeCenter QS21 |
|
|
079232G |
QS21 Blade (2 Cell BE
Processors) |
4 |
|
32R1760 |
Cisco Systems 4X Infiniband Expansion Card for IBM BladeCenter |
4 |
Il Blade QS21 costituisce una
soluzione blade ad altissimo throughput, particolarmente indicata per
applicazioni del tipo image processing, signal
processing e graphics rendering applications.
Il Dual
Cell-Based Blade 2 (DCBB2) dalla Mercury Computer Systems e’ un prodotto di
seconda generazione basato sul processore Cell Broadband Engine (BE) e sull’IBM BladeCenter.
Quattordici
unita’ single-slot DCBB2 riempiono uno chassis BladeCenter H, fornendo una
densità di processo maggiore di 1 TFLOPS per piede cubo.
Il DCBB2 ha
due processori Cell BE. Ogni processore che ha una frequenza di 3.2 GHz ha 205
sigle-precision GFLOPS di performance nel vettore SPE (synergistic processing
element), per un totale di 410 GFLOPS a blade.
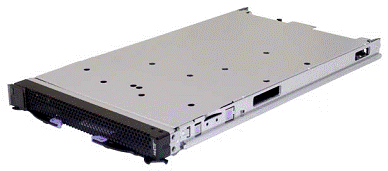
Può supportare fino a 2 CPU 3.2 GHz Cell
Broadband Engine™ technology (Cell BE). Questo nuovo tipo di processore, basato sulla tecnologia
Power Architecture™, è stato sviluppato in collaborazione con IBM, Sony
Corporation, Sony Computer Entertainment Inc., and Toshiba Corporation.
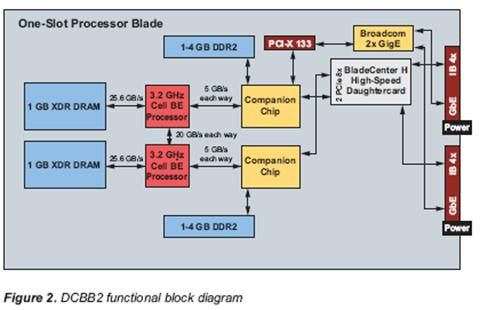
Le principali caratteristiche tecniche del blade QS21
sono:
Dual Cell BE Processors
PPE core IBM® 64-bit Power Architecture™
L1
cache size 32 KB
instruction; 32 KB data
L2
cache size 512 KB
SPEs 8
Local
store 256 KB
Registers
128 x 128 bits wide
EIB 205
GB/s sustained aggregate bandwidth
Processor internal clock speed 3.2 GHz
Processor-to-XDR-memory bandwidth 25.6 GB/s
Processor-to-processor coherent
interface 20 GB/s in each direction
Memory
XDR memory (each processor)
1
GB 3.2-GHz XDR DRAM, 2 channels per processor
DDR2 memory (each processor)
1
or 2 GB 667-MHz DDR2 organized as 2 VLP DIMMs per processor, 1 channel per DIMM
ECC support
Single-bit
correct; double-bit detect on XDR and DDR2
Flash 32
MB
NVRAM 1
MB
Storage
Optional Serial Attached SCSI controller
300 MB/s
I/O Subsystems
Dual Gigabit Ethernet port connected to
the midplane
Serial port Via midplane to rear of chassis
Serial over LAN Via BladeCenter Advanced Management Module
Removable storage BladeCenter MediaTray DVD/CD and USB
ports
Expansion Option
High-speed daughtercard
InfiniBand
4X HCA Expansion Card
Additional expansion options are being
qualified. Contact your Mercury sales representative
for details.
System Management
System management processor
Baseboard
management controller
MultiCore Plus™ SDK Software (Optional)
(32/64-bit application support)
MCF (MultiCore Framework) PPE/SPE
TATL™ (Trace Analysis Tool and Library) PPE/SPE
SAL (Scientific Algorithm Library) PPE/SPE
PixL™ (Image Processing Algorithm
Library) PPE
MCPDIAG (MultiCore Plus Diagnostics) PPE/SPE
SPEAD-K (SPE Assembly Development Kit) SPE
Linux operating system
Size
Length
Width
Height
The DCBB2 is a single-width blade server
in a BladeCenter H 9U chassis.
Environmental
Ambient temperature
Humidity 5-95% non-condensing
Altitude 3
Power
Total power 380W
Conforms to BladeCenter Open
Specifications
Compliance
European Directive 2002/95/EC
(RoHS
5/6 Server Exemption Directive)
I
4 blade QS21 sono alloggiati in un BladeCenter H.
Sezione 4
Definiamo
sezione 4 le 10 macchine IBM x3755( Scheda) 4 processori AMD Dual core 3,00
GHz con 16 Gb di ram contenute nell’armadio 2I.
Queste
macchine sono dotate di
·
6 schedeFPGA
VIRTEX5 LX330.pdf, il relativo ambiente di sviluppo Xilinx ISA 9.1 ed i
software di gestione;
·
4 schede grafiche NVIDIA
Quadro FX 4500 X2
|
Description |
Qty |
|
NVIDIA
Quadro FX4500 X2 |
4 |
|
FPGA
VIRTEX5 LX330 |
6 |
Tutte le
sezioni presenti nella sala sono controllate localmente attraverso 3 Consolle
collegate alle macchine attraverso un
sistema di KWM in cascata.
Reti di connessione
Il sistema di
calcolo offerto è connesso con le seguenti tipologie di rete:
-
rete
InfiniBand 4X DDR no blocking per il calcolo e accesso ai dati a alte
prestazioni;
-
rete
Gbit/s per tutte le funzioni di calcolo e accesso ai dati a prestazioni
limitate;
-
rete di
servizio per le operazioni di gestione del cluster e dei sistemi storage;
-
rete 10
Gbit/s per la connessione al centro stella della rete LAN dell’ENEA di Portici
-
SAN per
la connessione di tutti i sistemi dell’area dati ad alte prestazioni.
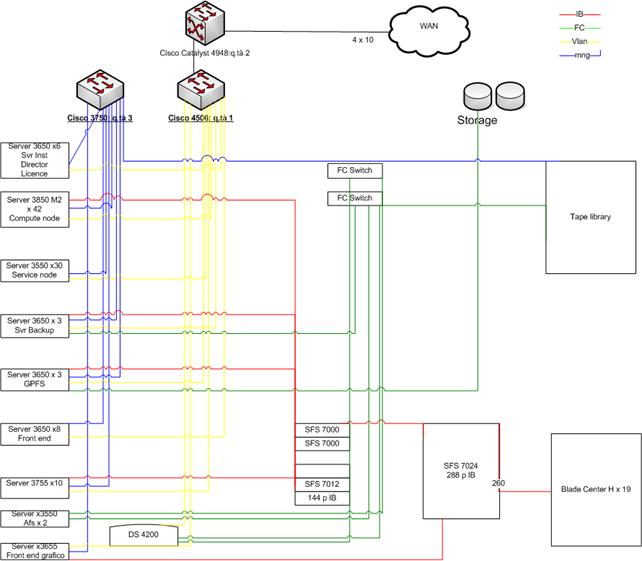
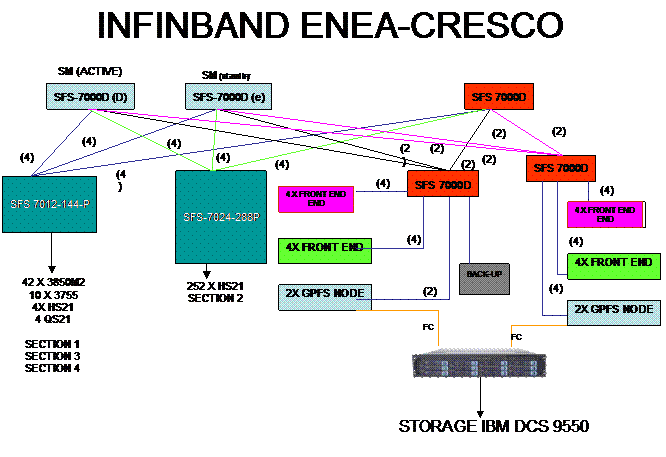
La figura
seguente riassume lo schema a blocchi dei componenti e dei sistemi connessi:
L’architettura
delle reti e’ stata disegnata tenendo in conto i seguenti punti qualificanti:
·
Rete
Infiniband: 4X DDR (20Gbits per link) no blocking che connette tutti i nodi di
calcolo della Sez 1 e 2, i GPFS Server,
·
Rete
Gbit che connette ogni Server con due reti di dati e di calcolo e una rete di
servizio preservando la separazione delle reti permettendo di mantenere fisicamente
separate le reti
·
Rete
di interconnessione alla LAN 10GbEth dell’ENEA
·
La
SAN che connette al sottosistema storage DS4200 e alla tape library addetta al
backup
Di seguito la lista delle macro componenti delle reti:
Infiniband (CISCO SFS 7000,7012,7024)
CISCO SFS 7024D 288 porte DDR
CISCO SFS 7000D 24 porte DDR
CISCO SFS 7012D 144 porte DDR
Gbit
CISCO
Catalyst 3560 48p 10/100/1000
SAN
CISCO
MDS 9124
10GbEth
CISCO SFS 3504 10GbEth Module
Infiniband
La rete di IPC
(Inter Process Communication) proposta garantisce una performace di 20Gbit/sec
(4x) da ogni nodo computazionale. Per questa ragione e per garantire che la
soluzione sia full non blocking e full bisection bandwidth la nostra scelta e’
caduta sull’utilizzo di switch Cisco Infinband
4x esterno per garantire ampliamenti dei vostri blade center e garantire sempre una performance di 20 gbit/sec
La nostra
soluzione propone prodotti della famiglia Cisco. La scelta di Cisco e’ dovuta
alla garanzia di perfomance ed affidabilita’ garantite da Cisco e da IBM
confermate.
Cisco con IBM
sta lavorando attivamente allo sviluppo sia dei nuovi prodotti per BladeCenter
H che al miglioramento e sviluppo di drivers e firmware per questa tecnologia.
Con l’acquisizione di Topspin, Cisco ha deciso di investire massicciamente in
questo settore e lo dimostra la leadership nello sviluppo di OpenIB ed il
rilascio dei drivers OFED in parallelo con quelli proprietari, oltre a lavorare
attivamente nello sviluppo di nuovi cavi, componente delle soluzioni infiniband
piuttosto delicata ad oggi.
Cisco inoltre ha partecipato alla realizzazione di 13
dei 20 cluster piu’ grandi basati su Infiniband e maggiori info sulle referenze
possono essere trovate all’URL
http://newsroom.cisco.com/dlls/2006/prod_111406f.html, di cui citiamo
- CINECA
- TriGrid
- Cybersar
- Cometa
- Sandia
National Laboratories
- the Air
Force Research Laboratory
- the
College of Computing at Georgia Tech,
- the
- the
- the
- Stanford
University
In particolare
Sandia National Laboratories Thunderbird Linux cluster e' classificato al 6
posto della Top 500 supercomputing list ed e' il piu grande cluster ad oggi
realizzato con standard Infiniband.
Ad oggi i
fornitori di Infiniband si relazionano con un unico fornitore di silicio, i
chip utilizzati da Cisco, Voltaire e Silverstorm dipendono dal silicio
realizzato da Mellanox da cui i produttori sopra menzionati acquistano le HCA.
La differenza nelle varie soluzioni IB sul mercato e’ percio’fatta dai drivers
e dal tipo di Systema di management utilizzato. Cisco ha realizzato un
software, chiamato Subnet Manager, molto
efficace che riesce a gestire e monitorare tutta
Le
specifiche di Infiniband, presenti sul
sito ufficiale IBTA
(http://www.infinibandta.org/home)
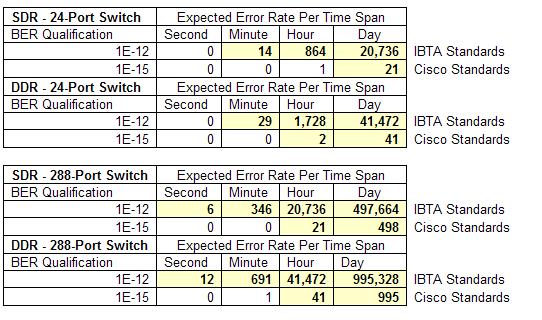
consentono un BER di 10-12 , Cisco supporta e qualifica il proprio HW
con specs piu’ restrittive (10-15 BER), tradotto in termini pratici: un BER di 10-12 corrisponde ad un rischio
di circa 1728 errori all’ora che si
riduce a due errori quando si utilizzano prodotti Cisco come quelli da noi
proposti nella nostra offerta. Nel caso di switch come il SFS-7024 completo di
288 porte DDR gli errori possibili possono essere circa 41 per ora a differenza
di prodotti che si attengono strettamente alle specifiche IBTA che consentono
circa 41472 errori all’ora, come evidenziato nella tabella seguente
Uno dei
componenti fondamentali delle soluzioni infiniband e’ il Subnet Manager, Cisco
ed IBM garanstiscono per questa soluzione un network fully managed in tutte le
sue componenti, grazie al Subnet Manager software fornito a corredo della
soluzione.
Le
caratteristiche principali del Subnet Manager di Cisco sono le seguenti:
- Unico nel
mercato con support hot-standby
- Capacita’
di “sweep” di 4600 nodi in 30 secondi
- Supporto
HA: se il master Subnet Manager dovesse avere un problema, si inneschera’
un meccanismo di failover del Subnet Manager per garantire la continuita’
del servizio.
- Configurazione
via CLI
- Ricalcolo
e load balancing dei package routes quando un cambio avviene un cambio
nella topologia del network
- Supporto
di MultiPathRecord che nel caso di utilizzo di entrambe le connessioni
presenti su ciascuna HCA, consente di non avere un SPOF.
- Supporto
di SNMP trap per permettere il management degli switch con i tools
standard forniti dall’industria per la gestione degli altri prodotti
Cisco.
- Cisco SFS
integra CiscoWorks con il supporto
di RME, DFM, NCM, TACACS.
Evidenziamo
che
Come gia’
accennato in precedenza, Cisco sta investendo risorse nello sviluppo di
Infiniband, a seguito dell’acquisizione di Topspin. Come prova di questa
affermazione ricordiamo che Cisco e’ uno dei maggiori contributori ad OFED ed
OpenMPI che includono:
- OFED’s
core architecture (Roland Drier-CISCO)
- IPoIB
(Roland Drier-CISCO)
- SRP
(Roland Drier-CISCO)
- Final
upstream kernel integration to Linux (Roland Drier-CISCO)
- OMPI
(Jeff Squyres-CISCO)
- Overall
OMPI direction and feature setting for OFED (Jeff Squyres-CISCO).
- QA on
OFED (Scott Weitzenkamp-CISCO).
Per la
soluzione proposta consigliamo di utilizzare lo stack software (librerie MPI,
drivers) proprietario fornito da Cisco che assicura, ad oggi, una maggiore
stabilita’ e sicurezza rispetto alla
versione OFED ancora in sviluppo.
Evidenziamo
che la soluzione da noi proposta è totalmente Fully Managed in tutte le
componenti Infiniband.
La soluzione
da noi offerta offre un’interconnessione
a alta efficienza Infiniband 4X Topspin/CISCO.
IBM ha un
accordo di collaborazione tecnologica con Myricom e il consorzio InfiniBand.
Per quest’ultimo partecipa alla definizione dello standard e alla sua
evoluzione (si veda www.infiniband.org) e ha inoltre stabilito con alcuni dei
principali produttori di architetture di rete (Topspin/CISCO, Voltaire) una
collaborazione tecnologica di lungo termine.
Tenuto quindi
in conto lo specifico ambito applicativo di interesse per AUTOSTRADE si e’ ritenuto particolarmente interessante
proporre una rete di interconnessione Infiniband-4X (di seguito IB) che
garantisca con il carico massimo di lavoro e con l’aumentare della potenzaq di
calcolo le perfomance di 20 gb/s .
Come e’ noto
IB e’ uno standard che si e’ imposto da qualche hanno e sul quale sono
convenuti i maggiori costruttori di soluzioni di rete, di sistemi storage e di
architetture cluster. IBM integra e supporta IB in tutta la gamma dei Server,
supporta lo sviluppo dei driver, del SW di gestione e dell’ambienti di
programmazione parallela MPI. Ha inoltre completato, o sta completando, la
migrazione di alcuni ambienti SW di gestione dei dati e di accesso efficiente
ai propri sistemi storage sfruttando i protocolli di comunicazione nativa.
L’utilizzo dei protocolli nativi consente di ottenere le maggiori prestazioni
in termini di latenza e bandwidth, vicini a quelli limite dell’architettura
stessa.
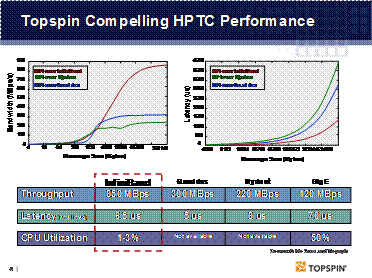
Di seguito si
riportano alcune chart da Topspin dove si evidenziano le peculiarita’ di IB
rispetto a altre connessioni ad elevate prestazioni.
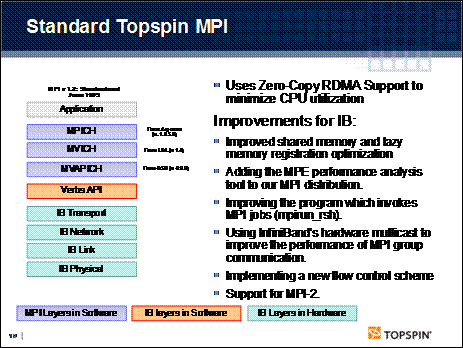
La
disponibilita’ di specifici driver con l’interconnessione IB Topspin consente
di sfruttare al meglio l’interconnessione tramite protocollo di programmazione
MPI supportato in MPICH e MPICH2. Questi due ambienti saranno installati nei
due clusters e verrano effettusate dei test di verifica di prestazione e di
funzionalita’ in collaborazione con il personale dei due centri stess
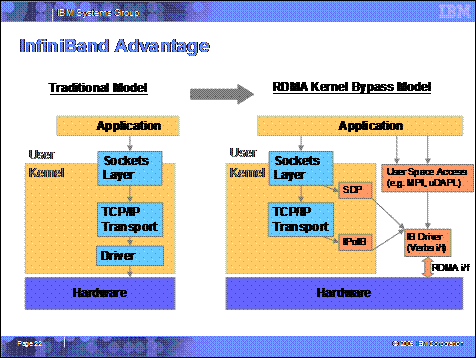
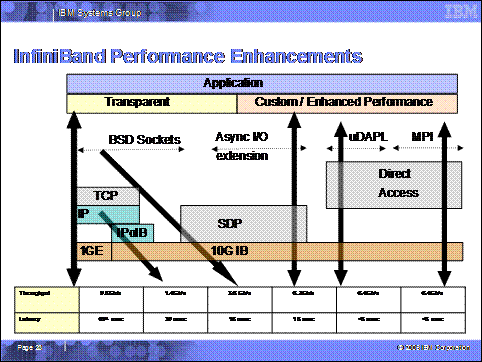
E’ altresi’
evidente che Blade Center H (BC-H) consentono di sfruttare a pieno le
caratteristiche dell’interconnesione 4X e quindi ottenere valori di latenza e
di throughput significativamente migliori.
Da notare
inoltre che i BC-H supportano una rete Gbit ridondata che consente il cluster
management e la comunicazione via LAN di tutte le Blades. Di seguito quindi un
riassunto sintetico delle specifiche di interconnessione Gbit e Infiniband 4X
specificatamente disegnate per questa realizzazione.
- 2 interfacce
di rete distinte (non una singola dual port)
Broadcom BCM 5708S ethernet 1
Gbit/sec
- 1
interfaccia di rete Cisco Systems 4X Infiniband
Chassis IBM
BladeCenter H da 9 U con questi componenti di rete:
- due
switch layer 2Gb E Rame a 6 porte ciascuno
- un
4X Infiniband Copper Pass Thru Module
- oppure Due
Switch Infiniband inseriti
all’interno del Blade Center
InfiniBand 4X
(10Gbps unidirectional, 20Gbps bidirectional) consente accessi a bassa latenza (ordine dei 3 microsec.),
elevata bandwidth (circa 1GByte/sec come valore di picco) e alta prestazione ad
ogni nodo blade indistintamente dalla posizione fisica dove risulta collocato.
Il disegno di
questo tipo di collegamento garantisce la scalabilità necessaria ad alti numeri
di nodi concorrenti ad un cluster HPC.
Le topologie
dell’HPC network basato su infiniband puo’ variare in base alle performance
necessarie ed al budget disponibile per tale componente del cluster linux. Una configurazione full non
blocking come quella proposta in questo documento consente la massima
disponibilta’ della bandwidth di Infiniband 4x, le HCA utilizzate hanno una
porta 4x che sfruttano la banda fornita dal bus PCI-E 8x caratteristiche delle blades
HS21..
Le
applicazioni ed i server che fruiranno dell’infrastruttura di calcolo hanno le
garanzie di adeguata sicurezza e privatezza
Il sistema di
interconnessione proposto consente l’ integrazione fra tecnologie di
connettività eterogenee per ottenere in sistema di rete unificato.
Il cablaggio
per InfiniBand 4X consente anche il supporto per nuovi protocolli quali il 10Gb
Ethernet piuttosto che l’8/10 Gb Fibra.
Non viene
fatto uso di protocolli proprietari ma vige il rispetto degli standard
internazionali, sia per i protocolli di rete impiegati, che per le
infrastrutture passive.
Per quanto
riguarda il collegamento Gbit – Rame del sistema di interconnessione High
Performance Infiniband 4x supporta banda
fino a 10Gbit unidirectional e 20Gbit bidirectional.
Sottosistema a dischi ad alte prestazioni e tape library
Per il
progetto CRESCO ha disegnato un’architettura SAN . L’infrastruttura in oggetto
si compone di due Switch FC CISCO modello MDS 9124, ciascuno corredato da 24
porte FC4 e tutte le componenti ridondate (Power e Ventole) che rappresentano
l’elemento centrale della Storage Area Network progettata.
Su questi due
switches verranno collegati:
- 4
connessioni FC verso la tape library
- 2
connessioni FC verso il sistema storage ds 4200
- 2
connessioni FC verso il server Master di BackUp
- 4
connessioni FC verso i Media Server di BackUp
- 4
connessioni FC verso i servers AFS
Per garantire
quindi una configurazione Fault Tolerant ha ritenuto di ridondare oltre agli
apparati switches anche tutte le connessioni FC tra le apparecchiature Storage
e
Altro elemento
di valutazione nel progettare questa infrastruttura è stato creare da subito la
integrazione tra i diversi protocolli di comunicazione per permettere ad ENEA di avere una visione
logica complessiva di tutta la infrastruttura consentendo l’utilizzo delle
risorse a prescindere dal protocollo di comunicazione utilizzato.
I prodotti che
saranno forniti per la realizzazione della soluzione sono :
|
Product Description
Qty |
|
|
|
2053-424 Cisco MDS 9124 Express for IBM System
Storage 1 |
|
1010
9124 Second Power Supply
1 |
|
4001
9124 8 Port Activation
2 |
|
5434
FC 4 Gb SW SFP Transceiver - 4 Pack
4 |
|
5605
5m 50u LC/LC Fiber Cable
24 |
|
9244
Power Cord CD12 ( |
|
|
|
2053-424 Cisco MDS 9124 Express for IBM System
Storage 1 |
|
1010
9124 Second Power Supply
1 |
|
4001
9124 8 Port Activation
2 |
|
5434
FC 4 Gb SW SFP Transceiver - 4 Pack
4 |
|
5605
5m 50u LC/LC Fiber Cable
24 |
|
9244
Power Cord CD12 ( |
DCS 9550
Il sistema DCS
9550 è composto da 1o 2 singlet controller che possono uniti insieme per
formare un couplet controller che è in grado di fornire una performance di
picco di 3.2 GB/s utilizzando 8 connessioni host .
Entrambi I
controller lavorano in modalità active-active non solo al fine di garantire 8
connessioni host attive ma anche un tempo praricmante uguale a zero in caso di
failover di.un controller . Nel backend del controller sono disponibili 20
connessioni FC per connettere I disk enclosure e garantire la banda elevata dal
controller all’host.
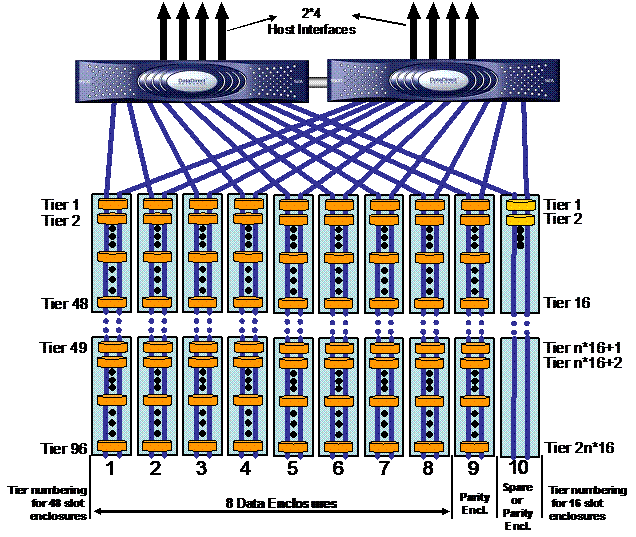
I cassetti
dicsco alloggiano 16 meccaniche. E’ in previsione l’annuncio del cassetto con
48 dischi.
L’IBM DCS 9550
fornisce una implementazione RAID denominata DirectRAID che offre un elevato
parallelismo distribuito sui dischi dei vari enclosures ed utilizza uno schema
di tipo 8+1+1.
Di fatto
vengono combinati ed utilizzati I lati positividelle protezioni RAID 3, RAID 5
e RAID 0. Come il RAID 3 viene utilizzato un disco per la parità all’interno del
(8+1) parity group. Il DirectRAID fornisce elevatissime prestazioni per pesanti
block-transfer – sia in READ che in WRITE – con nessun degrado di perfprmance
in crippled mode, caratteristica importante nel caso si utilizzi un file system
di tipo parallelo/shared.
Come il RAID
5, il DirectRAID non esegue il lock sui drive spindle e consente al disco il
re-order dei comandi per minimizzare la seek latency.
Più Raidsets
(o Tiers) posono essere raggruppati in una singola LUN e fornire una
funzionalità di tipo RAID 0. Queste PowerLUN possono coprire centinaia di
dischi ed offrire un elevatissimo throughput (oltre 2800MB/s nel DCS).
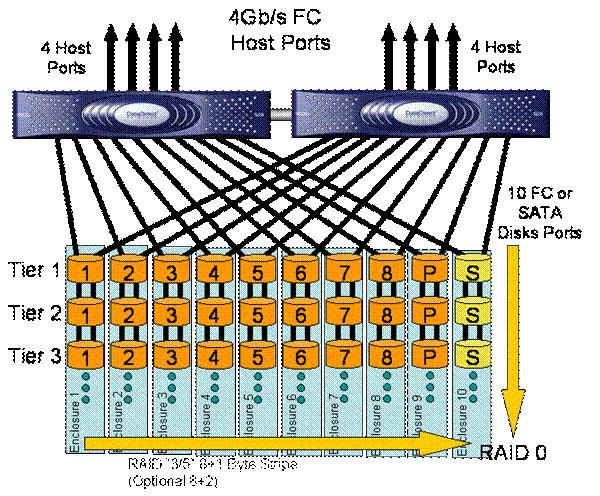
Come si vede
in figura I parity group (o "Tiers") di dischi sono formati da 9
drives (8+1) per volta, con fino a 112 drive hot spare.
Oltre alla
parità singola RAID (8+1) il sistema può essere configurato in parità RAID
doppia (8+2), ovvero RAID6.
Le
caratteristiche distintive del DCS possono essere riassunte in :
- Up to
2.8/3.0 GB/s per Read e Write
- RAID 6
(8+2) Redundancy
- No
performance degradation in crippled mode
- Partial
rebuild capability
- On the
fly single bit error correction
- High
density 48 Bay enclosures (scales to 480TB in one
- High
density allows cost savings in power consumption and floor space
- Drive
queue reorders on the fly
- Parity
computed Real time on Reads and Writes, not just Writes
- On the
fly data correction
- Huge
back-end performance for low-impact rebuild, disk scrubbing
- Unmatched
amount of drives (up to 1120) behind one single controller
- Large
cache which allows to configure “LUN in Cache”
- High
level of redundancy
Il DCS 9550 si
integra in una a rchitettura con più nodi server in un parallel file system
grazie alla sua carattteristica di virtualizzare l’accesso alla singola LUN per
server specifici. Sono anche supporte le funzioni di:
- LUN
Aliasing (virtualization)
- LUN in
Cache
- LUN
Masking
- LUN
Zoning by host WWN
- LUN
Zoning by Port
- LUN
Permissions
- Read/Write
- Read only
- Zero
capacity placeholder LUNs
- LUN
Cloning (directMirror)
Con DIRECTMON,
un server connesso agli storage controller possono essere eseguite le
operazioni di installazione, management, Remote logging, E-mail o Phone
notification, etc...
Il sistema DCS
può essere configurato sia via CLI che attraverso la GUI (opzionale) .
Informazioni
aggiuntive possono essere trovate presso il sito
CONFIGURAZIONE DCS9550 PER ENEA-CRESCO
.
La
configurazione DCS9550 offerta presenta le seguenti caratteristiche ambientali.
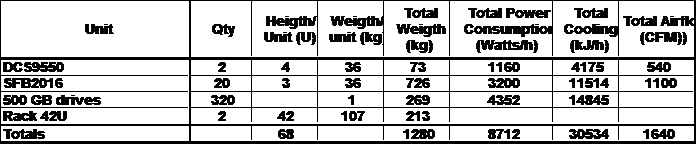
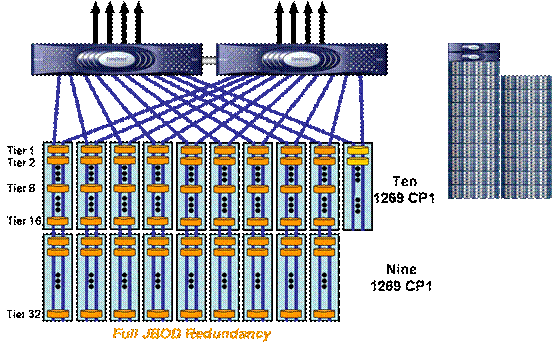
Un sistema con
20 enclosure occupa 2 rack e presenta una configurazione come quella riportata
in figura (RAID singolo).
Caratteristiche
di merito preferenziali relative al sistema di dischi ad alte prestazioni
offerto:
|
Caratteristiche
di merito preferenziale |
IBM
DCS 9550 |
|
Attivazione
delle connessioni IB con la sez 2 |
Attivabile |
|
Una
uguale velocità in lettura e scrittura |
uguale
velocità di lettura e scrittura |
|
La
verifica della parità in scrittura e lettura |
La
verifica della parità avviene sia in lettura che in scrittura |
|
Il
livello di degrado delle prestazioni nella fase di ricostruzione del dato
espresso in percentuale di degrado rispetto al valore delle prestazioni di
picco |
Il
livello di degrado in fase di ricostruzione del dato è percentualmente trascurabile |
|
La
potenza elettrica necessaria al funzionamento e l’eventuale presenza di
funzioni sleep mode |
La
potenza elettrica per l’intero sistema è di 8712 watts/h consente
l’attivazione del funzionamento in Sleep Mode |
|
La
possibilità di avere dischi con diverse capacità (500Gb e 1000Gb) sullo
stesso controller |
500,
750 e 1000Gbyte sullo stesso controller |
|
Capacità
grezza minima 120TB |
160
TB |
La
configurazione comprende 32 Tier con doppia parità composto ciascuno da 10
dischi ( vedi ABCDEFGHPS ).
DCS9550[1]: tier
Tier Status
Space
Capacity Available Disk
Tier Owner
(Mbytes) (Mbytes) Status LUN List
-----------------------------------------------------------------------------
1 + 1
3815470 0 ABCDEFGHPS
1
2 + 2
3815470 0 ABCDEFGHPS
2
3 + 1
3815470 0 ABCDEFGHPS
3
4 + 2
3815470 0 ABCDEFGHPS
4
5 + 1
3815470 0 ABCDEFGHPS
5
6 + 2
3815470 0 ABCDEFGHPS
6
7 + 1
3815470 0 ABCDEFGHPS
7
8 + 2
3815470 0 ABCDEFGHPS
8
9 + 1
3815470 0 ABCDEFGHPS
9
10 + 2
3815470 0 ABCDEFGHPS
10
11 + 1
3815470 0 ABCDEFGHPS
11
12 + 2
3815470 0 ABCDEFGHPS
12
13 + 1
3815470 0 ABCDEFGHPS
13
14 + 2
3815470 0 ABCDEFGHPS
14
15 + 1
3815470 0 ABCDEFGHPS
15
16 + 2 3815470 0
ABCDEFGHPS 16
17 + 1
3815470 0 ABCDEFGHPS
17
18 + 2
3815470 0 ABCDEFGHPS
18
19 + 1
3815470 0 ABCDEFGHPS
19
20 + 2
3815470 0 ABCDEFGHPS
20
21 + 1
3815470 0
ABCDEFGHPS 21
22 + 2
3815470 0 ABCDEFGHPS
22
23 + 1
3815470 0 ABCDEFGHPS
23
24 + 2
3815470 0 ABCDEFGHPS
24
25 + 1
3815470 0 ABCDEFGHPS
25
26 + 2
3815470 0 ABCDEFGHPS
26
27 + 1
3815470 0 ABCDEFGHPS
27
28 + 2
3815470 0 ABCDEFGHPS
28
29 + 1
3815470 0 ABCDEFGHPS
29
30 + 2
3815470 0 ABCDEFGHPS
30
31 + 1
3815470 0 ABCDEFGHPS
31
32 + 2
3815470 0 ABCDEFGHPS
32
La
capacità totale del sistema è 122095040 Mbytes.
Il numero delle lun è 32 ( una per tier ). La capacità
totale di ogni lun è 3815470MB
DCS9550[1]: lun
Logical Unit Status
Capacity Block
LUN Label
Owner Status (Mbytes) Size
Tiers Tier list
-------------------------------------------------------------------------------
1 1 Ready 3815470 512
1 1
2 2 Ready 3815470 512
1 2
3 1 Ready 3815470 512
1 3
4 2 Ready 3815470 512
1 4
5 1 Ready
3815470 512
1 5
6 2 Ready 3815470 512
1 6
7 1 Ready 3815470 512
1 7
8 2 Ready 3815470 512
1 8
9 1 Ready
3815470 512
1 9
10 2 Ready 3815470 512
1 10
11 1 Ready 3815470 512
1 11
12 2 Ready 3815470 512
1 12
13 1 Ready 3815470 512
1 13
14 2 Ready 3815470 512
1 14
15 1 Ready 3815470 512
1 15
16 2 Ready 3815470 512
1 16
17 1
Ready 3815470 512
1 17
18 2 Ready 3815470 512
1 18
19 1 Ready 3815470 512
1 19
20 2 Ready 3815470 512
1 20
21 1
Ready 3815470 512
1 21
22 2 Ready 3815470 512
1 22
23 1 Ready 3815470 512
1 23
24 2 Ready 3815470 512
1 24
25 1 Ready 3815470 512
1 25
26 2 Ready 3815470 512
1 26
27 1 Ready 3815470 512
1 27
28 2 Ready 3815470 512
1 28
29 1 Ready 3815470 512
1 29
30 2 Ready 3815470 512
1 30
31 1 Ready 3815470 512
1 31
32 2 Ready 3815470 512
1 32
Lo
mappatura attuale su entrambe le controller è la seguente :
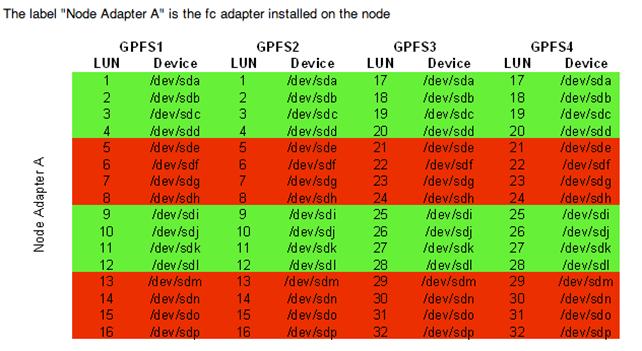
In pratica i primi due nodi GPFS1 e 2 vedono entrambi
le prime 16 lun; GPFS 3 e 4 vedono le successive 16 lun ( da
La 3584 e le
unità in essa contenute potranno essere accessibili da più server in maniera
dinamica senza spostare fisicamente cavi o connessioni di altro genere. Sarà
altresì possibile assegnare anche gli slot delle cassette in maniera dinamica
da un server ad un altro, senza richiedere alcun fermo di produttività, tramite
l’opzione ALSM.
Con il
software di gestione grafica con interfaccia WEB, sarà possibile controllare le
normali operazioni della tape library e il suo stato di funzionamento.
L’aggiunta di
ulteriori unità nastro potrà avvenire senza modifiche alla dimensione esterna
della tape library, e senza ridurre il numero di slot delle cassette. E’
altresì possibile aumentare il numero delle unità nastro riducendo il numero
degli slots o aggiungendo ulteriori frames.
In termine di performance, sono riportati nella
tabella i tempi di caricamento, movimento e scaricamento delle cassette:
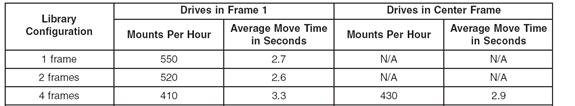
Nel dettaglio,
il numero di mount per ora identifica il numero di cassette che la tape library
può montare in un’ ora.
Nella fase di mount (tempo di ciclo) sono comprese le
seguenti operazioni:
1. Rimozione
della cassetta dall’unità nastro
2. Re-inserimento
della cassetta nello slot corrispondente
3. Estrazione
della cassetta da un altro slot in maniera casuale
4. Spostamento
della cassetta verso l’unità nastro
5. Caricamento
della cassetta nell’ unità nastro.
L’Avarage Move
Time esprime il valore medio del tempo impiegato dalla robotica per prendere
una cassetta da uno slot casuale, posizionarsi di fronte all’unità nastro ed
inserire la cassetta stessa.
In caso di
spegnimento il tempo fra accensione e il pronto all’ uso è di circa 15 secondi
più il tempo di inventario pari a circa 60 secondi per frame.
Il valore di
MTBF della libreria è pari a 64,1 mesi, mentre i rispettivi valori di MTTR sono
inferiori a 30 minuti.
Specifichiamo
che i dati sopra indicati sono strettamente confidenziali e sono stati ottenuti considerando un’attività
di 15.000 mount/dismount per mese.
Per la
manutenzione delle parti interne nella
Tape Library, non è previsto alcun spegnimento della stessa; in particolare la
rimozione delle alimentazioni elettriche (libreria e unità nastro) e delle
unità nastro avvengono a caldo (hot-swap) senza interruzione del servizio. Solo
in caso di guasto della robotica dovrà essere pianificato un fermo del servizio.
A richiesta è disponibile l’opzione di ridondanza che comporta l’aggiunta della
frame HA.
La doppia
copia dei Vital Product Data e del Microcodice della Tape Library, permettono
gli aggiornamenti a caldo senza interruzione del servizio.
In caso di
guasto
I requisiti per l’installazione sono riassunti nella
seguente tabella:
|
Specifiche
TAPE LIBRARY 3584 |
Valore |
|
Alimentazione
elettrica |
220V
monofase |
|
Presa
elettrica (Doppia) |
IEC 309
Type P+ |
|
Assorbimento
elettrico configurazione offerta - max (16 frames, 192 unità nastro) |
3.2KVA -
25,6KVA |
|
Peso
configurazione offerta - max (16 frames, 192 unità nastro) |
701Kg -
8000KG |
|
Umidità
Relativa Operativa |
20%-80% |
|
Temperatura
Operativa °C |
16- |
|
Dissipazione
termica configurazione offerta - max
(16 frames, 192 unità nastro) |
3,12kBTUora
- 53,12kBTUora |
La tecnologia
LTO
LTO (Linear
Tape-Open) é una tecnologia standard industriale scaturita da un'iniziativa
di IBM, Hewlett-Packard e Seagate che
hanno fissato regole di alta capacità ed elevate prestazioni per lo storage a
nastro in piattaforma Unix, NT ed AS/400, con l’obiettivo di facilitare anche
l'interoperabilità dei formati in ambienti open. In sostanza la nuova
tecnologia offre la possibilità di scambiare
nastri di qualunque produttore che adotti il sistema LTO, fornendo
dunque una valida alternativa ai diversi formati proprietari attualmente
utilizzati nel settore. Dal 1°settembre 2000 é stato possibile con i drive IBM
LTO Ultrium, di prima generazione, disporre di una capacità nativa di 100 GB
(ovvero una capacità compressa di 200 GB) per cartuccia. Il drive IBM LTO
Ultrium di prima generazione permette data transfer di 15 MB/sec (30 MB con
compressione 2:1).Dall’inizio del 2002 IBM ha gradualmente introdotto per le
proprie librerie i drive LTO Ultrium di seconda generazione, che accrescevano
sia la capacità, da 100 GB a 200 GB nativi, sia il data transfer, passando da
15 MB/s a 35 MB/s nativi. Dall’inizio del 2005 IBM ha introdotto, per prima in
assoluto nelle proprie librerie, i drive LTO di terza generazione raddoppiando
di fatto sia la capacità (400GB nativi) sia il data transfer (80MB/s) rispetto
la precedente generazione. Da aprile 2007 IBM ha introdotto i drive LTO di
quarta generazione raddoppiando di fatto sia la capacità (800GB nativi) sia il
data transfer (120MB/s) rispetto la precedente generazione.
Dati ufficiali
e documentazione tecnica sono disponibili presso il sito :
http://www.ibm.com/storage/lto
Il mercato
“target” per l’LTO Ultrium é l’Open Systems midrange e i sistemi in rete
che richiedono ormai sempre più spesso
elevate prestazioni e alta disponibilità dove, quindi le tecnologie concorrenti
(SuperDLT, DLT 7000/8000, 8mm Mammoth, AIT, 9940) potrebbero non essere più
sufficienti.
La
caratteristica qualificante della tecnologia LTO é quella di utilizzare
componenti che rispettano gli standard fissati, così che i Clienti potranno riutilizzare Ultrium LTO
media di un fornitore/costruttore anche in sistemi LTO acquisiti da fornitori
differenti. Ciò consente di massimizzare gli investimenti nel LTO allungando di
fatto la vita utile dei beni con la garanzia di prezzi contenuti grazie alla
possibilità di acquisire HW LTO scegliendo tra fornitori diversi.
Per LTO, inoltre, sono già state fissate precise
regole per garantire la futura evoluzione.
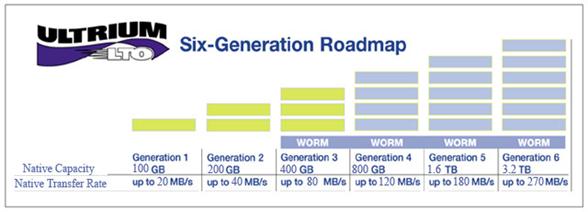
Dal punto di vista
dell’affidabilità le cartucce LTO hanno vantaggi notevoli:
·
La vita utile di un nastro IBM Ultrium data cartridge
viene garantita sino a 30 anni, con un possibile decadimento di segnale non
superiore al 5%.
·
Il leader-pin interno é in metallo con possibilità di
rottura praticamente azzerate
·
(rispetto per esempio alla cartuccia DLT con
leader-pin di plastica ciò costituisce un notevole passo avanti).
·
Sono previste servo-tracce, come nei nastri della
tecnologia Magstar. Questa è una novità
assolutamente unica per prodotti di questa fascia di mercato e assicura maggiore precisione di lettura/scrittura.
·
Le servo tracce presenti sul nastro inviano alla
testina di lettura/scrittura segnali elettronici che garantiscono il perfetto
allineamento sulle tracce ogni volta che il nastro viene letto, scritto,
riavvolto o fatto avanzare
·
Il dispositivo ECC (Error Correction Control) permette
di verificare i livelli di soglia di vari componenti per segnalare possibili
malfunzionamenti
·
Interfaccia fibre channel a 2 Gbps nativa in grado di
supportare sia il protocollo FC-SW che
FC-AL. Non necessita, a differenza di soluzioni della concorrenza, di bridge
SCSI-to-FC che costituiscono sia un collo di bottiglia per le performance di
questo nuovo tipo di drive che un single point-of-failure
·
Speed matching. Il drive IBM LTO Ultrium dalla seconda
generazione in poi, è in grado di funzionare a 5 velocità differenti in modo da
adattarsi al throughput sostenibile dal server ed evitare il fenomeno
denominato backhitch (continui arresti e ripartenze del nastro)
·
Sleep mode. Permette di ridurre il consumo elettrico
del drive.
·
Partial Response Maximum Likelihood Encoding (PRML).
Questo algoritmo permette di archiviare gli stessi dati utilizzando un 33% in
meno del nastro.
La quarta
generazione dei drive LTO Ultrium di IBM introduce poi una serie di ulteriori
vantaggi:
·
Capacità nativa delle cartucce 800GB (fino a 1600 GB
con dati compressi con un fattore 2:1)
·
Data transfer di fino a 120 MB/s nativi (240 MB/s
compressi)
·
Maggiore cache per i drive IBM LTO-Gen4 rispetto ai
drive LTO-Gen3 (256 MB di cache contro 128 MB del modello precedente).
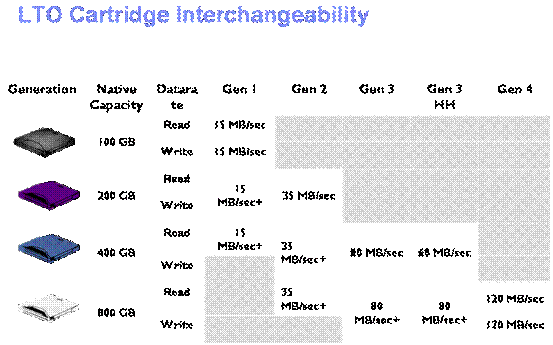
Pur essendo
successivamente variata la cartuccia tra i drive LTO delle varie generazioni, è
presente una compatibilità in lettura/scrittura come da figura:
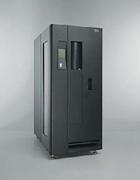
Il modello
3584 è stato progettato per rispondere alle esigenze dei clienti che
necessitano di soluzioni per l'archiviazione dei dati, il backup, funzioni di
disaster recovery ed altre esigenze di storage.
LaTape Library
e’ composta da una frame base mod. L53 dove sono presenti la robotica
principale, uno dei due library accessor (braccio meccanico) con dual-grip, i
tape driver (da
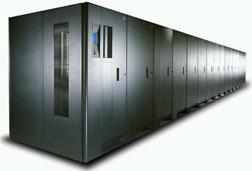
Affiancando le
frames aggiuntive mod. D53 (D33 per i drive 3592/TS1120) è possibile aumentare
il numero dei tape driver (max. 192) ed il numero dei slot per nastri (max.
6887).
L’aggiunta
della frame mod. HA1, contenente il secondo library accessor, garantisce
ulteriore affidabilità e performance (minor tempo di montaggio nastri). Tutte
le frame possono essere dotate di alimentazione ridondata. Da notare che i
drive LTO-4 supportano nativamente l’importante funzione di Encryption per una
gestione in sicurezza dei dati.
Altre caratteristiche di base presenti sono:
Ÿ Auto-Calibrating
Ÿ Persistent
World Wide Names (WWN)
Ø WWN
è assegnato allo slot del drive in modo tale da evitare impatti al server e
allo zoning quando un drive viene sostituito
Ÿ Backup/Restore
dei Vital Product Data (VPD) automatico
Ø VPD
è automaticamente salvato/ripristinato
quando un componente è sostituito
Ÿ Funzione
di Inventory automatico
Ÿ Interfaccia
Medium Changer scsi-3
Ÿ Display
LCD Touch Screen
Ÿ Finestra
per controllo interno a vista
Ÿ Sportello
di accesso bloccabile meccanicamente ed elettronicamente
Ÿ Manutenzione
“concurrent” con drive hot-swap
Ÿ Collegamento
diretto con un centro di supporto IBM. La libreria potrebbe altresì preventivamente monitorata e manutenuta a
distanza (funzione di call home).
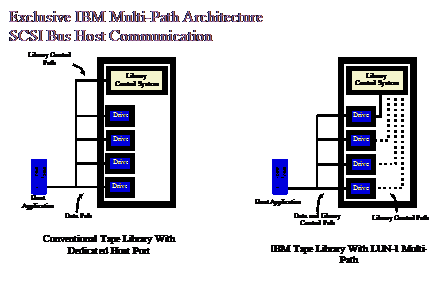
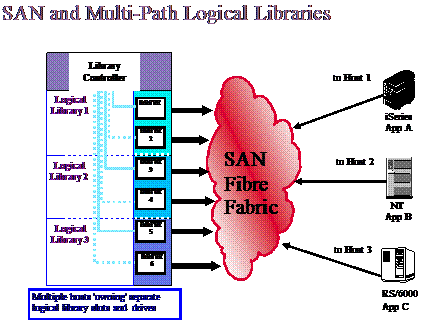
Ÿ Multi-Path
Architecture
Ø Virtualizza
il braccio robotico
Ø Permette
il partizionamento logico e/o la condivisione della libreria da parte di SW di
backup differenti
Ø Permette
il collegamento diretto senza l’utilizzo di un router SCSI-to-FC integrato
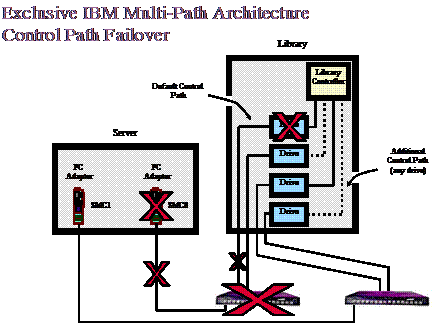
Permette la creazione di Control Path per la robotica ridondati
A queste caratteristiche vanno aggiunte le seguenti
features avanzate :
Ÿ Control
Path Failover (attualmente disponibile per AIX e Linux)
Ø Presenta
il vantaggio di permettere l’utilizzo di control path ridondati verso la
robotica
Ø Supporta
il failover automatico verso schede fibre channel, SAN o control path della
libreria ridondati
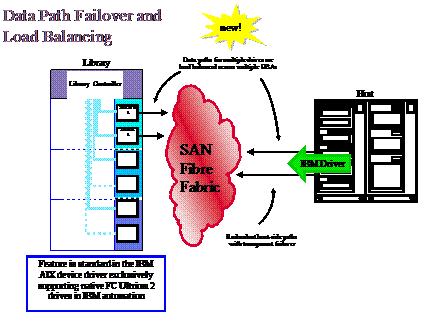
Ÿ Data
Path Failover (attualmente disponibile con drive LTO Ultrium 2, 3, 4 e sistema
operativo AIX)
Ø Supporta
il failover automatico verso una scheda e/o uno switch fibre per i dati
Ÿ Load
Balancing (adesso disponibile con drive LTO Ultrium 2, 3, 4 e sistema operativo
AIX)
Ø Supporta
il Load Balancing tra schede fibre channel che si connettono a dei nastri LTO
Ÿ ALMS
(Advance Library Management System) è un software integrato 3584 con
interfaccia GUI per la gestione dinamica della libreria (upgrade di frame “ a
caldo”, riallocazione dei drive, condivisione di drive attraverso logical
partition), raggiungibile via browser web e compatibile con vari server e
sistemi operativi.
Ø Partizionamento logico e dinamico dei tape
driver e slot.
La libreria
3584-L53 è poi in grado di ospitare cartucce LTO-Gen1, LTO-Gen2, LTO-Gen3 ed
LTO-Gen4 in diverse modalità sia nella stessa libreria logica che in librerie
logiche separate grazie all’architettura
Multipath.
Le matrici di
compatibilità sono liberamente consultabili ai siti:
http://www.storage.ibm.com/tape/lto/3584/3584opn.pdf
http://www.storage.ibm.com/tape/lto/3582/3582opn.pdf
http://www.storage.ibm.com/tape/conntrix/pdf/lto_isv_matrix.pdf
Server Master di Back Up
Per la funzione di Server Master di BackUp sarà
fornito un server IBM modello x3650 configurato con due CPU Intel QuadCore
E5345 80W 2.33GHz/1333MHz/2x4MB L2, 2 Gb di memoria RAM 4 porte Gigabit
Ethernet, 2 porte FC 4Gb/s, 2 HDD da 146Gb SAS, Sistema Operativo RedHat Linuk
64bit Enterprise server, Veritas NetBackup 6.
Media Server
Per la funzione di Media Server di BackUp saranno
forniti due servers IBM modello x3650
ciascuno configurato con due CPU Intel QuadCore E5345 80W 2.33GHz/1333MHz/2x4MB
L2, 2 Gb di memoria RAM 4 porte Gigabit Ethernet, 2 porte FC 4Gb/s, 2 HDD da
146Gb SAS, Sistema Operativo RedHat Linuk 64bit Enterprise server, Veritas
NetBackup 6.
IBM System x3650
Componenti Software
Di seguito si
riportano i prodotti software utilizzati nel progetto. il supporto necessario
alla realizzazione delle procedure per il corretto utilizzo degli applicativi;
-
il corretto funzionamento dei componenti software e
dei servizi principali di sistema.
Metodologia utilizzata per l’installazione del Cluster
IBM
a cura di
Alberto Falzone
Introduzione.
Lo strumento
adottato per l’installazione dei nodi afferenti al cluster è SystemImager
(wiki.systemimager.org), seguendo il criterio di clonazione di immagini di nodi
di riferimento, denotati “golden nodes”.
Oltre che per
le installazioni dei nodi, tale strumento si rivela utilissimo nel mantenimento
degli stessi e per la propagazione degli aggiornamenti software che si
ritengono necessari effettuare.
SystemImager è
ospitato sul server tipo x3650, cresco-inst0.portici.enea.it, dedicato
esclusivamente a svolgere le funzioni di server repository per le installazioni
dei nodi.
SystemImager è
anche stato integrato con BitTorrent per consentire una efficiente scalabilità
nel trasferimento delle immagini sui singoli nodi nel caso di un deployment
massivo.
Requisiti e
implementazione.
Requisiti
soddisfatti preliminarmente alla installazione dello strumento SystemImager
sono:
- installazione del server DNS
locale per la risoluzione dei nomi di tutti i nodi appartenenti al
cluster; allo scopo si è definito il dominio locale “vlancresco” al quale
fare afferire le definizioni per la risoluzione diretta e inversa; il
server DNS ha inoltre funzioni di forwarding verso il DNS di
portici.enea.it per la risoluzione dei domini internet;
- installazione del server
DHCP per l’assegnazioni degli indirizzi IP basate sui MAC Address delle
schede Ethernet che insistono sulla
vlan;
- installazione del server
TFTP tramite il quale, combinato al DHCP, è gestita la fase di bootstrap
dei nodi via PXE.
- Rsync attivo.
L’implementazione
ha richiesto l’installazione dei pacchetti rpm come documentata sul sito http://wiki.systemimager.org/index.php/Quick_Start_HOWTO
, la configurazione dei servizi systemimager oltre alla aggiunta come “add-on”
di systemimager-bittorrent per la integrazione della tecnologia Bittorrent come
sistema di trasporto.
Successivamente
si sono individuati i “golden nodes” su cui si sono installati il sistema
operativo RedHat Enterprise 5.1 x86_64 ed aggiornamenti via yum, le librerie software richieste dall’utenza ed
i tools necessari alla integrazione in ambiente ENEA-Grid; essi sono:
cresco1x001,
cresco1x005 per la sezione 1
cresco2x003
per la sezione 2
cresco1-f1
per tutti i nodi di front-end non grafici (sez. 1 e sez. 2)
cresco1-fg1
per tutti i nodi di front-end grafici (sez. 1 e sez. 2)
Si è quindi
proceduto a preparare i nodi per l’acquisizione delle loro immagini,
introducendo anche il versioning delle stesse; segue la lista delle immagini
attualmente registrate:
[root@cresco-inst0
~]# si_lsimage
--------------------------------------------------------------------------------
Available
image(s):
--------------------------------------------------------------------------------
blade_rhel51_v1
blade_rhel51_v2
frontend1_rhel51_v1
frontend1_rhel51_v2
nodes_32gb_rhel51_v1
nodes_32gb_rhel51_v2
quadcore_64gb_rhel51_v1
quadcore_64gb_rhel51_v2
[root@cresco-inst0
~]#
Definiti i
nodi appartenenti alle relative immagini, attivatone il boot PXE si è proceduto
al deployment massivo via bittorrent con tempi dell’ordine di 30 min su oltre
250 clients.
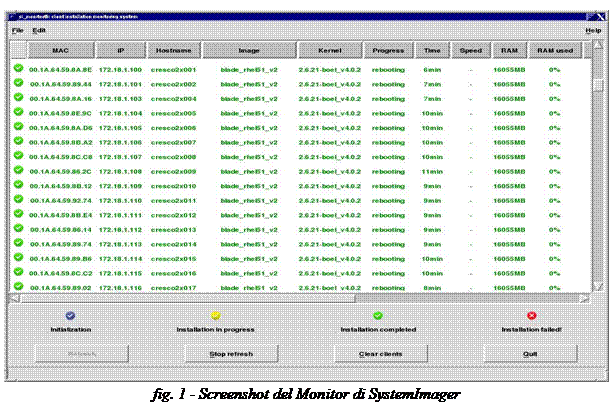
SystemImager
prevede anche un addon per il monitoraggio delle installazioni che è stato
installato su cresco-inst0 e tramite il quale può essere seguito il
trasferimento dell’immagine ed il buon esito della vera e propria installazione
grazie al meccanismo di redirezione della consolle durante tutta la fase di
trasporto (fig.1).
Segue la
configurazione dei gruppi di nodi afferenti alle immagini, organizzate per
range numerici:
<group>
<name>Blades</name>
<priority>40</priority>
<image>blade_rhel51_v2</image>
<override>Blades</override>
<node>cresco2x001-cresco2x002,cresco2x004-cresco2x256</node>
</group>
<group>
<name>QuadCore64GB</name>
<priority>40</priority>
<image>quadcore_64gb_rhel51_v2</image>
<override>QuadCore64GB</override>
<node>cresco1x002-cresco1x004,cresco1x033-cresco1x040</node>
</group>
<group>
<name>ComputingNodes32GB</name>
<priority>40</priority>
<image>nodes_32gb_rhel51_v2</image>
<node>cresco1x006-cresco1x032,cresco1x041-cresco1x042</node>
</group>
<group>
<name>FrontEndNodes</name>
<priority>40</priority>
<image>frontend1_rhel51_v2</image>
<override>FrontEndNodes</override>
<node>cresco1-f2,cresco1-f3,cresco1-f4,cresco2-f1,cresco2-f2,cresco2-f3,cresco2-f4</node>
</group>
Posteriormente
alla installazione si sono eseguite operazioni di post-install per la
definizione degli ip address sulle interfacce di rete gigaethernet e infiniband
e il flash del firmware su quest’ultime laddove resosi necessario.
Software di
sistema
Il sistema
operativo offerto è Linux 64 bit supportato dalla distribuzione RedHat Enterprice 64 bit, nella più recente
versione, per piattaforma Intel per HPC
Node di seguito si specifica:
-
il livello e la qualità del supporto garantito: 12
mesi
-
la certificazione dell’hardware delle sezioni 1 e 2: i
sistemi sono certificati per il supporto a Linux RedHat.
Software di
gestione e di monitoring del sistema
installato
Queste
funzioni saranno raggiunte tranmite l’installazione e la personalizzazione dei
seguenti componenti software, che verranno rese disponibili su tutti i sistemi
installati:
Il software di sistema IBM Director, fornito con tutti
i server xSeries, consente di svolgere sul server xSeries molteplici
funzionalità tra le quali elenchiamo le principali:
- Gestore
di sistemi remoti
- Insieme
di tool integrati con interfaccia grafica che offre un singolo punto di
gestione
- Automatizza
task quali la raccolta degli inventari, Hardware e Software, controllo di
risorse, gestione di allarmi hardware, reazione ad eventi critici o
informativi, help desk e stato di salute dei sistemi.
- Supporta
più sistemi operativi su sistemi IBM e non-IBM
- Integrazione
verso i principali software di gestione enterprise (Tivoli, CA, HP
Openview, MS SMS, BMC, netIQ, MOM)
- Fornisce
una framework di base nella quale si possono integrare altri tool per una
gestione ancora più avanzata
- Interfaccia
grafica facile da utilizzare e che supporta il drag and drop dei task sui
sistemi target o sui gruppi di sistemi target
- Possibilità
di programmare i task per essere eseguiti in un determinato istante
(scheduler grafico).
- Supporto
di una riga comandi per eseguire diversi task
- Tool
Update Assistant per la distribuzione automatizzata di aggiornamenti di
sistema quali microcode e driver.
- Database
centralizzato che rende disponibili le informazioni relative ai sistemi
anche se questi non dovessero essere disponibili
- Gestione
di dispositivi che supportano il protocollo SNMP
- Supporto
e gestione fino a 5000 sistemi.
La struttura
di IBM Director è client server, come si può vedere dalla seguente figura.
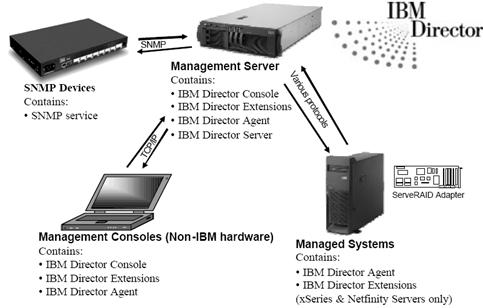
L’ IBM Director software ha tre componenti principali:
- IBM
Director Server
- IBM
Director Agent
- IBM
Director Console
Un server centrale ospita il motore dell’ applicazione
e la connessione opzionale ad un database relazionale (che può risiedere su un
altro server applicativo). Sulle
macchine da gestire viene installata la componente agent di IBM Director che
fornisce le funzionalità di comunicazione con il server applicativo.
Ci sono tre livelli di IBM Director Agent:
- Level
0 (agentless Management):
- Gestione Base comprendente:
- Discovery, login, Attributi, Power Control, Inventario base,
Remote Session (Linux)
- Aggiornabile ai Level 1 o
Level 2 attraverso IBM Director server stesso.
- Level
1 (core services):
- Tutte le funzionalità del livello
- Gestione dei Log, Piani di azione, stato e controllo
dell’hardware, inventario specifico per la piattaforma, Integrazione
verso gestori più enterprise (come Tivoli).
- Level
2 (IBM Director Agent):
- Tutte le funzionalità del prodotto.
Per accedere ai task di gestione è necessaria la
componente Console di IBM Director (che viene installata per default anche
sulla macchina che fa da server). Tale Console può essere installata su un
numero n di macchine (server o pc di amministrazione) ma deve avere una
connessione TCP/IP con il server IBM Director. La console è illustrata nella
seguente figura.:
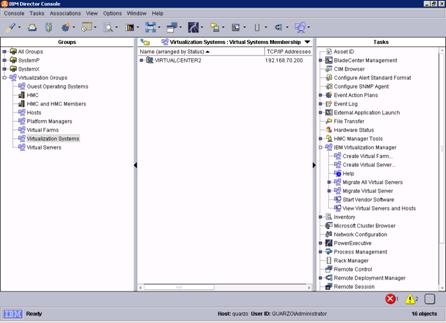
Nella parte di sinistra sono indicati i gruppi di
macchine (alcuni predefiniti, altri definibili dall’ utente), nella colonna
centrale è indicato il contenuto del gruppo selezionato, nella task bar in alto
sono presenti i vari task. Gli agenti possono essere registrati in maniera
automatica grazie al meccanismo di discovery oppure possono essere aggiunti
manualmente. I task possono essere eseguiti sulle singole macchine o su gruppi
interi di macchine. La comunicazione fra Director Server e
Agent è sicura poiché viene utilizzato un meccanismo basato su chiavi pubbliche
e provate. Questo impedisce che un server IBM Director installato da personale
non autorizzato possa gestire gli agenti senza autorizzazione.
La comunicazione fra server e agente utilizza il
protocollo DSA (Digital Segnature Authentication) per valicare le richieste di
gestione. Tutto il traffico fra server e agente può essere crittografato usando
il metodo DES (Data Encryption Standard) o Triple DES. Inoltre IBM Director
utilizza il protocollo SSL per la comunicazione da Console a Server.
All’ apertura della console vengono richieste le
credenziali di un utente di sistema operativo (dominio o workgroup) autorizzato
alla gestione. Ogni utente può personalizzare la propria console. Inoltre
l’amministratore può configurare la console dei vari utenti in modo da
applicare specifiche restrizioni a task o gruppi sulla base del ruolo dell’
utente. I task eseguibili remotamente sono:
- Visualizzazione
di AssetID.
- Gestione
e configurazione dei BladeCenter.
- Capacity
Manager (opzionale, richiede licenza aggiuntiva)
- Visualizzazione
dei dati CIM .
- Configurazione
di Alert Standard Format
- Configurazione
degli agenti SNMP (su sistemi operativi Microsoft) e delle configurazioni
di rete.
- Visualizzazione
degli allarmi generate da eventi vari e dei cambiamenti dello stato
hardware.
- Creazione
di piani di azione a seguito di eventi.
- Lancio
di applicazioni esterne (richiede configurazione)
- Trasferimento
di file
- Visualizzazione
dei dati di inventario con la possibilità di costruire query ad hoc .
- Gestione
dei processi e avvio/arresto di processi e servizi sulla macchina gestita.
- Controllo
remoto dei sistemi gestiti.
- Sessione
remota sui sistemi gestiti (equivalente a telnet o rcmd di Microsoft,
sebbene basata
- su
tecnologia proprietaria IBM).
- Gestione
dei processori di sistema (schede Remote Supervisor Adapter).
- Controllo
di file critici (cancellazione, modifica).
- Gestione
dei cluster Microsoft (MSCS).
- Gestione
dei dispositivi SNMP.
- Gestione
delle schede ServeRAID.
- Programmazione
dell’ esecuzione di task a tempi definibili dall’ utente (scheduler)
- Distribuzione
di pacchetti software (la versione Premium richiede licenza aggiuntiva)
- Automazione
del processo di restart di un sistema operativo.
I criteri di raggruppamento delle macchine gestite si
basano su inventari software e hardware o sul semplice elenco di server. Gli
eventi (malfunzionamenti hardware o allarmi su servizi di sistema operativo e
risorse) vengono notificati localmente come menu popup (funzionalità
disabilitabile) e vengono inseriti nel log del sistema operativo. Inoltre
vengono anche comunicati a IBM Director server in maniera automatica. Il server
esegue poi le azioni che sono state configurate. Tali azioni comprendono
l’invio di e-mail (è richiesto un server SMTP esterno), l’esecuzione di task
IBM Director o di batch file generici (definiti dall’ utente), la modifica
delle viste nella console (inserire i sistemi con dei problemi all’ interno di
un certo gruppo o visualizzare i sistemi con un icona indicante lo stato -
critical, warning, information ). Durante il processo di inventario,
vengono raccolte informazioni relative ai numeri Field Replaceable Unit (FRU)
per l’hardware installato e immagazzinati del database relazionale. Inoltre
questi numeri vengono inclusi negli allarmi hardware, minimizzando il tempo durante
l’apertura del ticket verso il centro di supporto IBM per ordinare le parti di
ricambio. Attraverso l’utilizzo del tool
Electronic Service Agent è possibile fare sì che a fronte di un guasto hardware
di una macchina gestita il server IBM Director apra in maniera automatica un
ticket verso il centro di supporto IBM (attraverso una connessione Internet
sicura o via modem). IBM provvederà alla sostituzione delle parti in garanzia
secondo i livelli di servizio concordati. IBM Director non rileva soltanto i problemi
hardware ma predice potenziali malfunzionamenti e guasti. Le componenti
hardware che supportano gli allarmi di pre-rottura (Predictive Failure Analysis
o PFA) sono:
- Dischi
- Memoria
- CPU
- Ventole
- VRM
(Voltage Regulator Module)
- Alimentatori
Qualsiasi evento o azione eseguita vengono registrati
sul server IBM Director. Inoltre gli eventi relativi a ciascuna macchina
gestita vengono inseriti nel log del sistema operativo locale (funzione che è
possibile disabilitare). I report sui livelli di servizio possono essere
costruiti con l’ausilio del tool System Availability scaricabile dal sito web.
Il Capacity Manager controlla l’utilizzo delle risorse
Hardware come processori, memoria, dischi e traffico di rete, identifica i
colli di bottiglia e dà raccomandazioni per il miglioramento delle prestazioni.
Il tool è opzionale e richiede licenza aggiuntiva. Il Rack Manager è un
interfaccia grafica che permette di costruire l’immagine grafica di un rack e
dei suoi componenti. Dà indicazioni sulla salute del sistema in toto.
System Availability traccia e fornisce diverse viste
grafiche dei livelli di servizio di un singolo sistema o di gruppi di sistemi.
Maggiori informazioni sul systems management IBM si
possono trovare al seguente link (in inglese):
http://www-03.ibm.com/servers/eserver/xseries/systems_management/index.html
IBM Power Executive (PE) è un tool gratuito per
sistemi X e BladeCenter che consente di misurare i consumi effettivi ed
emissioni di calore, per ottimizzare l’energia usata da un singolo o da un
gruppo di server in qualsiasi momento.
PE comunica direttamente con L’Advanced Management Module nei sistemi
BladeCenter e col BMC service processor per i sistemi X ed ha un proprio
database (Apache Derby) diverso dal database dell’IBM Director, in cui vengono
memorizzati i dati e i power object. Power Executive supporta le
seguenti tipi di blades:
- IBM
BladeCenter HS20 (8843)
- IBM
BladeCenter HS21 (8853)
- IBM
BladeCenter LS20 (8850)
- IBM
BladeCenter LS21 (7971)
- IBM
BladeCenter LS41 (7972)
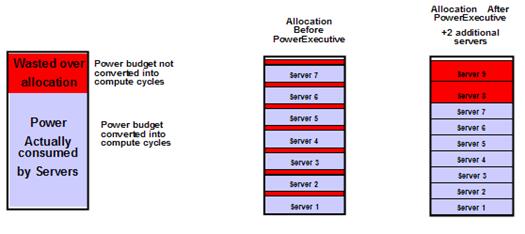
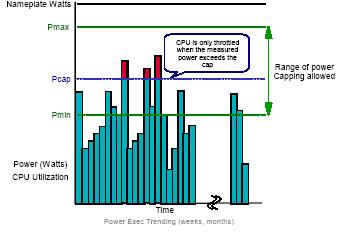
Dato che il consumo energetico sarà uno dei grandi
temi futuri anche per l’It, PowerExecutive consentirà ai clienti di sviluppare
policy personalizzate ridistribuendo dinamicamente le risorse energetiche
ottimizzando i consumi del data center. Infatti, come è mostrato nella figura
seguente, un sistema, viene sempre dimensionato con un certo valore nominale di
potenza, che è sempre maggiore di quella effettivamente utilizzata dal server.
Power Executive permette di monitorare il consumo effettivo in potenza, in
conseguenza di ciò è possibile ridistribuire le risorse in eccesso per alimentare server aggiuntivi.
Il programma è dotato di un’interfaccia grafica,
riportato nella figura in basso, sulla
quale è possibile visualizzare la potenza istantanea e la temperatura in
funzione del tempo del BladeCenter.
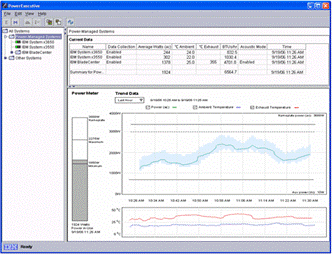
Il Power Executive è in grado di monitorare:
- Alimentatori
- Blades
- I/O
modules
- Advanced
management module
- Ventole
- Media
tray
- Midplane
Inoltre in Power Executive 2.0 è possibile stabilire
delle soglie (power cap Pcap), con cui limitare la potenza consumata dalle
blade o dai server.
Ciò significa che se il sistema richiede più potenza
di quella stabilita dal valore Pcap, allora la CPU sarà throttled. Il range dei
valori che può essere assegnato a Pcap, va da Pmin a Pmax che sono calcolati
dinamicamente dal BMC o dal AMM in base alla configurazione del sistema.
Tutto il sw di gestione potrà essere installato,
comprendendo nell’installazione la definizione
della procedura automatica di installazione completa di tutti i nodi
della sezione 1 e
Tale valutazione fa riferimento ad una situazione di piena disponibilità ed efficenza dei
sistemi e della rete, nonchè dei locali ove i tecnici possono svolgere la loro
attività.
Middleware
ENEA-GRID
Riteniamo
utiule aggiungere qualche elemento in relazione al prodotto LSF Multicluster
LSF, un
prodotto software realizzato da Platform Computing, è la soluzione leader
per il Workload Management, in grado di trasformare un gruppo di workstation e
server in un "calcolatore virtuale multiprocessore a memoria non
condivisa", ottimizzando l'uso di tutte le risorse dell'Azienda.
LSF fornisce
servizi di load balancing per sessioni interattive ed applicazioni parallele,
oltre ad un completo e flessibile sistema di network batch queuing &
scheduling, anch'esso pensato per il bilanciamento dinamico e lo sfruttamento
ottimale di tutte le risorse (eterogenee) della rete (LAN o WAN), che
appariranno all'utente come un'unico sistema.
Platform LSF
MultiCluster massimizza la necessità di condividere risorse virtualizzate oltre
il singolo cluster LSF per creare un singolo cluster virtuale esteso su diverse
locazioni geografiche separate, fornendo una singola immagine virtuale
attraverso i cluster integrati.
Con LSF
MultiCluster i permessi e i controlli locali sono mantenuti e viene garantito
l'accesso prioritario ai cluster locali quando viene fornito un accesso globale
nella grid Enterprise.
Benefici di
MultiCluster:
In
un'organizzazione i siti posso avere LSF cluster separati ed indipendenti.
Havere cluster LSF multipli può risolvere problemi relativi a:
• Facilità
di amministrazione
• diverse
locazioni geograficamente distinte
• Scalabilità
Quando si
hanno più di un cluster, è desiderabile permettere ai cluster di cooperare per
ottenere i seguenti benefici di una condivisione globale delle risorse:
• Accesso
a diverse collezioni di risorse computazionali
• Trasformare
l'Enterprise Grid Computing in realtà
• Ottenere
migliori performance e capacità computazionali
• Utilizzare
le macchine idle per eseguire jobs
• Utilizzare
molte macchine per eseguire un singolo job parallelo
• Incrementare
la produttività degli utenti
• Aggiungere
risorse ovunque e renderle disponibile all'intera organizzazione
• Pianificare
globalmente le risorse computazionali in base alla domanda complessiva
• Aumentare
la potenza computazionale in modo economico
MultiCluster
permette ad un'organizzazione distribuita di formare cluster cooperanti di
computer in modo che la condivisione del carico non sia distribuita solo sui
singoli cluster, ma tra i vari cluster.
Il progetto preliminare del sistema di backup
Il
Sistema di Backup sarà basato sul Software Veritas NetBackup qui di seguito
andiamo a descrivere il Sistema proposto nel suo complesso quindi nelle sue
parti Software ed Hardware e della relativa modalità di implementazione ed
integrazione con il sistema preesistente:
Licenze Software:
Come da richiesta del capitolato, che scaturisce dalla
necessità di compatibilità con il sistema preesistente ENEA, il sotware proposto è Veritas NetBackup vers.
6.
|
Licenza |
Vers. |
Q.ty |
|
NetBackup Server,Linux,Enterprise
Server,v6.0,License Tier 1 |
6 |
1 |
|
NetBackup Server,Linux,SAN Media Server,v6.0,License
Tier 1 |
6 |
2 |
|
NetBackup Option,Cross Platform,Library Based Tape
Drive Support,v6.0,License |
6 |
4 |
|
NetBackup Option,Cross Platform,Shared Storage
Option,v6.0,License |
6 |
4 |
|
NetBackup Client,Linux,Enterprise Server,Advanced
Client,v6.0,License Tier 3 |
6 |
1 |
|
NetBackup Client,Linux,Enterprise Server,Advanced
Client,v6.0,License Tier 1 |
6 |
1 |
|
NetBackup Option,Linux,Bare Metal Restore Client.v6.0,License |
6 |
2 |
Implementazione della soluzione:
L’implementazione prevede l’installazione del Master
Server Veritas e dei 2 Media Server su piattaforma Linux, il patching dei
sistemi operativi e la loro connessione alla SAN.
L’installazione del software NetBackup Linux
Enterprise Server sul Master Server e l’installazione del software NetBackup
SAN Media server sui 2 Server
Media preposti con l’opzione Bare Metal Restore ed NetBackup Shared Storage Option che
consentirà ai 2 Media Server di condividere i 4 Drive presenti nel Tape
Library.
Seguirà quindi l’installazione sui 2 nodi principali
del software Veritas NetBackup parte Client e l’abilitazione della feature
“Bare Metal Restore” per entrambi i 2 nodi principali delle sezioni 1 e 2 (16 Core ed 8 Core).
Oltre alle normali funzionalità di back up presenti
nel Client Veritas, intendendo per tali
il salvataggio standard dei dati, KSI per facilitare al massimo le
operazioni di restore propone la funzione Bare Metal Restore (BMR) per NetBackup questa soluzione di tipo
enterprise è concepita per il ripristino rapido di sistemi client in ambiente
UNIX, Windows e come nel nostro caso LINUX, BMR è un prodotto complementare
integrato con Veritas NetBackup, BMR semplifica e ottimizza il processo di ripristino
del server,eliminando la necessità di reinstallare manualmente i sistemi
operativi o di configurare l'hardware, questo, come evidente, permetterà al
sistema HPC dell’ENEA il restore dei client in un tempo molto breve cosa che
non sarebbe possibile con una semplice recovery dei dati in quanto questa
sarebbe possibile solo dopo la reinstallazione del sistema operativo, riteniamo
quindi che questo sia elemento di merito della nostra proposta in quanto il
tempo di ripristino per entrambi i nodi principali del sistema HPC oggetto
della fornitura non dovrà comprendere la reinstallazione del sistema operativo
ed il relativo Patching, ma consentirà di reimportare oltre che i dati, lo
stato del sistema stesso al momento del
back up. Questa feature consente inoltre il salvataggio di più impostazioni,
cioè configurazioni diverse per lo stesso server (Nodo) fornendo una maggiore
elasticità caratteristica importante per un sistema dedito alla ricerca.
Integrazione del sistema BU CRESCO con il sistema
preesistente
La integrazione con il sistema preesistente sarà
immediato visto che i due sistemi sono basati sulla stessa release di software,
l’unica condizione è che il nostro personale tecnico incaricato della
implementazione sia abilitato da ENEA ad avere i necessari privilegi di rete
per permettere ai due sistemi di interfacciarsi, una volta abilitati sarà
quindi possibile monitorare da una qualsiasi delle sedi ENEA (Casaccia,
Brindisi, Trisaia e Portici) lo stato dei BackUp del sistema CRESCO.
Questo lo schema logico del sistema integrato con il
preesistente:
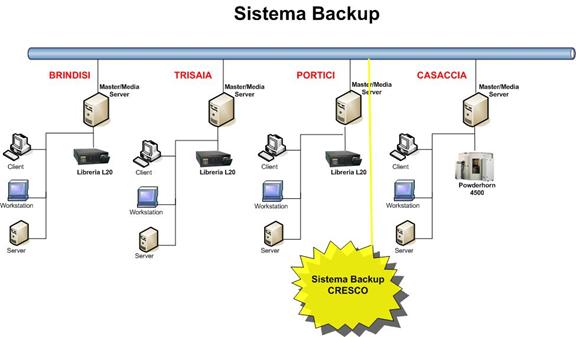
Collaudo
Test preliminari al rilascio della soluzione:
Nell’ambito dei test che verranno effettuati prima del
rilascio della soluzione, sono previste 2 tipologie di test, una relativa ai 2
nodi ed una relativa allo storage.
Per quanto riguarda il test sui 2 nodi, verrà
effettuato un back up dei sistemi nella loro integrità, comprensivi quindi di
tutte le impostazioni e settaggi presenti, ed un loro ripristino totale
attraverso i dati salvati nel tape Library,
Il tempo previsto per la “reinstallazion” di
ciascun nodo in “crash” è di un’ora.
Si può in questo ambito pensare, in caso di “failure
hardware”, all’installazione dei dati e del setup del nodo anche su un nodo
secondario previsto al momento del “settaggio” del software Veritas per evitare
in tal modo tempi di lavoro “inutilizzabili”.
Per ciò che concerne invece lo storage, e dando scontata l’alta affidabilità dello stesso, si
è pensato come unico test veramente riproducibile, il salvataggio ed il
conseguente Restore di un intero cassetto fisico dello storage.
Considerando il trasfer rate offerto da 2 schede HBA
FC 4Gbit affiancate, la considerazione numerica e temporale per i periodi di
restore è di seguito riportata:
Un cassetto completo di 16 dischi da 500 Gb porta ad
un valore complessivo raw di 8Terabyte.
La soluzione globale offerta dalla implementazione IBM
GPFS e Veritas garantirà un restore dei dati per un totale di 12 TeraByte in un
tempo di 24 ore.
Per quanto concerne infine il back up delle “celle”
AFS, lo stesso verrà riprodotto, con le dovute differenze, sulla base di quanto
già garantito dalle soluzioni già precedentemente implementate nelle 4 sedi di
Trisaia, Brindisi, Portici e Casaccia.
Riepilogando , il tempo di ripristino medio per 500Gb
dal tape verso lo storage deve considerarsi effettuabile in un tempo oscillante
fra i 60 ed i 65 minuti.
Il tempo di restore di uno dei 2 Nodi principali è da
considerarsi di un’ora.
Una volta terminata l’installazione software ed hardware,
il personale KSI/Veritas, in collaborazione con i tecnici IBM e sotto la
supervisione del personale ENEA valuterà lo schedulamento , i tempi e le
metodologie di back up (policy) che ENEA riterrà più idonee alle proprie
esigenze. Le policy di Back Up saranno
comunicate da ENEA al nostro personale che si occuperà di assegnarle al sistema
secondo le desiderate del cliente.
Training
E’ previsto sul nuovo sistema di Back Up un training
per il personale che ENEA ci indicherà da tenersi presso
Sistema di sicurezza
La rete
privata dei sistemi di calcolo oggetto della fornitura è configurata secondo
uno schema
di due classi
di rete, uno su IP pubblico (il nodo di front end) e l’altro su IP nascosto.
Tale
configurazione garantirà un livello di sicurezza in linea con le richieste
delle vostre specifiche tecniche.
Sistema
di alimentazione e di continuità
A –
Configurazione proposta : UPS da
400 kVA – autonomia 20 minuti
Ø 1
UPS ns. tipo GALAXY 6000 da 400 kVA tri/tri
- caratteristiche elettriche in ingresso :
- tensione d’ingresso nominale 380/400/415V
trifase + neutro
- tolleranza
della tensione d’ingresso : +/-
15%
-
tolleranza della frequenza d’ingresso : 50
o 60 Hz +/- 10%
- Fattore di Potenza in
ingresso : 0,85
- frequenza nominale : 50Hz
-
caratteristiche elettriche in uscita :
- potenza
nominale : 400
kVA
- potenza
attiva : 320
kW
- tensione d’uscita nominale : 380/400/415V trifase + neutro
- variazione
dinamica della tensione :
3% impatti di carico da 0 al 100%
- THDU a
vallle su carico non lineare : Ph/Ph
<2%,Ph/N <3% - sovraccarico ammesso : 125% -10 mn, 150% - 1mn
- Fattore di potenza in
uscita : 0,8
- frequenza : 50Hz 0,5%
Ø Caratteristiche
tecniche
-
on-line doppia conversione
-
raddrizzatore dodecafase
-
nuova tecnologia IGBT
- by-pass
statico
- by-pass manuale di manutenzione
- avvio progressivo
- sistema « battery monitor » indica
l’autonomia reale disponibile e la vita presunta della batteria in base ai
parametri dell’installazione
-
display LCD con misure e allarmi
- storico
cronologico degli avvenimenti
- conduttore
di neutro sovradimensionato
- arresto
d’urgenza a distanza (sgancio batterie, ingresso UPS, contattore statico)
- collegamento dal basso
- rendimento
elevato
- possibilità
di ridondanza e messa in parallelo
- possibilità
di filtaggio attivo /passivo e modalità Eco Intelligent
- ISO 9001 e
14001, prestazioni conformi EN50091-3 e certificazione TüV
1 messa in
servizio :
-
ottimizzo dei parametri di personalizzazione in funzione delle esigenze del
sito
-
verifica dei collegamenti elettrici
-
accensione e verifica corretto funzionamento
-
spiegazione delle principali operazioni al personale addetto
1 documentazione
completa di uso e manutenzione
- L’UPS sarà
collegato secondo il layout “Apparecchiature Sala Quadri.pdf”.
- E’ previsto
un doppio ingresso dal quadro QGBT BIS
- Le linee di
alimentazione a monte ed a valle dell’UPS sono dimensionate in base alla
distanza ed alla potenza richiesta.
- Ogni Rack è
alimentato e protetto da due linee di alimentazione da 32Amp trifase con
interruttori magnetotermici differenziali
- Sono
previsti due collegamenti per Armadi Rack per un totale di n°26 linee di
alimentazione ed interruttori da installare nel quadro elettrico esistente
Allegati
5.
IBM Director
6.
Lame Cell
7.
Configurazione Storage DDN/GPFS
8.
Procedure di installazione Cluster